
Код товара: 5384546609


Постоплата
Новинка
Новинка
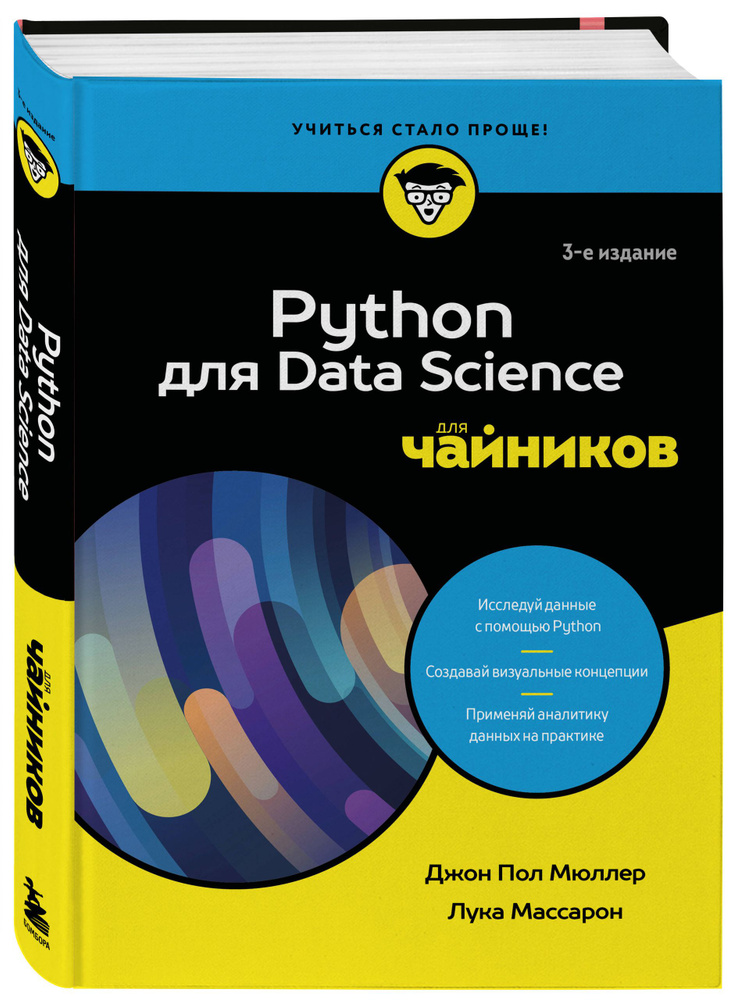
Python для Data Science для чайников, 3-е издание | Массарон Лука
Тип книги:
Печатная книга
О товаре
Перейти к описанию
Автор
Автор на обложке
Джон Пол Мюллер, Лука Массарон
Серия
Год выпуска
2026
Тип бумаги в книге
Офсетная
О книге
Книга посвящена применению языка Python в задачах Data Science. В ней рассматриваются основные этапы работы с данными: получение информации из файлов и баз данных, очистка и преобразование данных, ана
1 816 ₽
Магазин
Подписаться
ЭКСМО
Перейти4.9
Чат
Заказы
756 K
О магазине
Часто задаваемые вопросы
Другие предложения от продавцов на Ozon Россия
Описание
Книга посвящена применению языка Python в задачах Data Science. В ней рассматриваются основные этапы работы с данными: получение информации из файлов и баз данных, очистка и преобразование данных, анализ, визуализация и построение моделей машинного обучения.
Читатель познакомится с экосистемой Python для анализа данных, включая NumPy, pandas, Scikit-learn, TensorFlow, Keras и другие библиотеки. В издании представлены методы описательной статистики, корреляционного анализа, кластеризации, поиска аномалий, снижения размерности и оценки качества моделей. Также рассматриваются вопросы подготовки признаков, перекрестной валидации, подбора гиперпараметров и работы с большими наборами данных.
Третье издание содержит примеры для актуальных версий Python, новые наборы данных и материалы по современным подходам к обработке информации. Книга может использоваться как вводный курс по Data Science и как справочный материал при изучении инструментов анализа данных на Python.
#python
#python_книга
#программирование
#компьютер
#языки_программирования
#АйТи
#IT
#клавиатура
#data_science
#наука_о_данных
- Артикул
- 5384546609
- Автор
- Массарон Лука
- Автор на обложке
- Джон Пол Мюллер, Лука Массарон
- Серия
- Для "чайников"
- Год выпуска
- 2026
- Тип бумаги в книге
- Офсетная
- Тип обложки
- Твердый переплет
- Тип книги
- Печатная книга
- Язык издания
- Русский
- Количество страниц
- 512
- Размеры, мм
- 242х170х26
- Вес товара, г
- 790
- ISBN
- 978-5-04-201412-3
- Возрастные ограничения
- 12+
- Оригинальное название (для переводных изданий)
- Python for Data Science for dummies
Подборки товаров в категории Книги: Компьютерные технологии
Отзывы о товаре
0
Python для Data Science для чайников, 3-е издание | Массарон Лука
Рейтинга пока нет. Он формируется на основе актуальных отзывов на заказанные и оплаченные товары
Как правильно задавать вопросы?
Будьте вежливы и спрашивайте о товаре, на карточке которого вы находитесь
Если вы обнаружили ошибку в описанием товара, воспользуйтесь функцией
Как отвечать на вопросы?
Отвечать на вопросы могут клиенты, купившие товар, и официальные представители.
Выбрать «Лучший ответ» может только автор вопроса, если именно этот ответ ему помог.